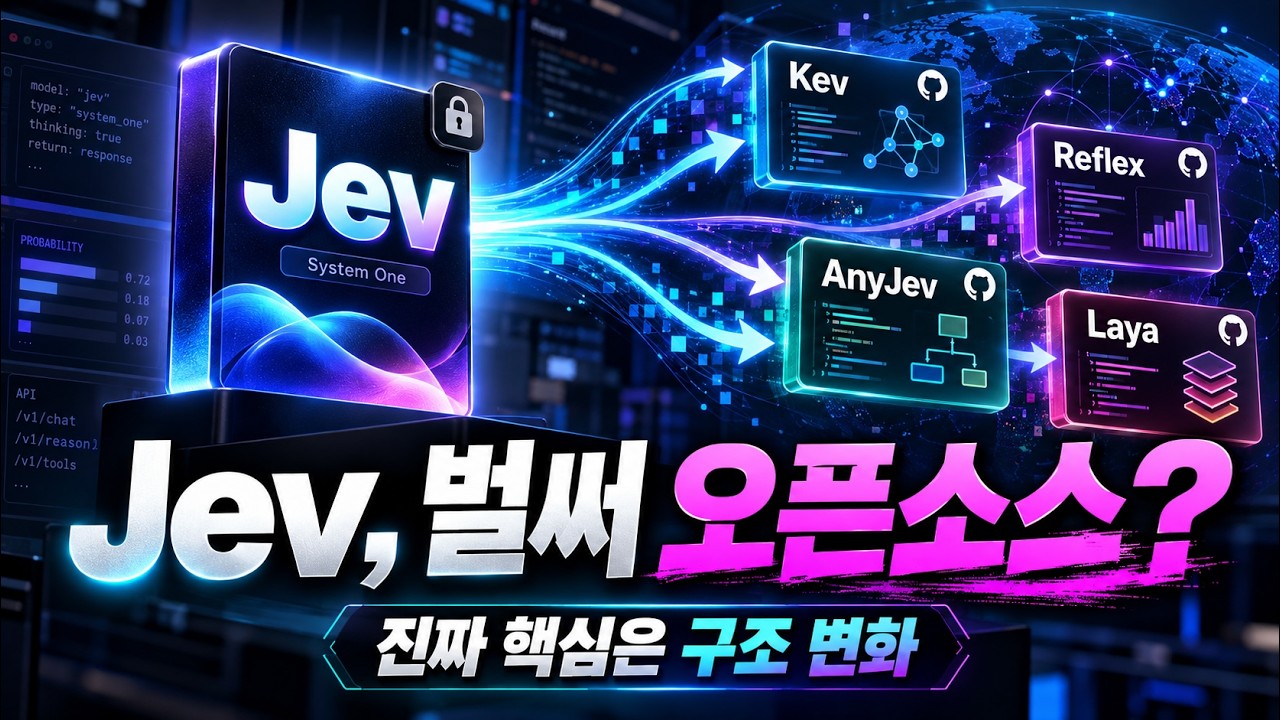
제브 공개 일주일 만에 오픈소스가 따라붙었다. 캡, 리플렉스, 애니제브 같은 구현이 연달아 나오면서 이제 질문이 바뀐다. 진짜 중요한 것은 제브라는 제품인가, 아니면 제브가 보여준 새로운 구조인가. 결론부터 말하면 구조다. 반복되는 작은 판단은 작고 빠른 디시전 모델이 먼저 처리하고, 애매하고 어려운 문제에서만 큰 추론 모델을 호출하는 아키텍처가 표준으로 가고 있다는 것이다.
Jev 공개 일주일 만에 오픈소스가 따라붙었습니다
핵심 요약
- 제브의 핵심 아이디어는 문장을 생성하지 않고 선택지·점수·예/노 같은 결정 자체를 확률과 함께 반환하는 것이다. 소프트웨어가 바로 쓸 수 있는 판단을 돌려주는 모델.
- 9월 15일 공개된 제브 소개글이 해커 뉴스에서 1,900포인트, 댓글 500개 이상의 반응을 만들었다.
- 캡(QN 계열 기반, 0.8B~27B 크기, 타입세이프 API 호환), 리플렉스(단일 포워드 패스, 약 200ms 응답), 애니제브(기존 LLM의 로짓·히든 스테이트를 판단 엔드포인트로 변환, 캘리브레이션 강조), 라이언(비자동회기 방식, 다국어 지원) 등이 잇달아 등장했다.
- 올라 같은 프로젝트는 오픈 디시전 모델을 올라마처럼 풀하고 런하고 서브하는 경험을 만들고 있다.
- 남은 검증 과제는 처음 보는 도메인에서의 일반화, 확률과 실제 정답률의 일치, 어려운 문제에서의 성능 유지.
- 개발자가 확인할 세 가지: 반복 판단이 많은가, 그 판단을 명확한 형식으로 표현할 수 있는가, 신뢰도가 낮을 때만 큰 모델이나 사람에게 넘길 수 있는가.
상세 정리
제브가 주목받은 이유
기존 언어 모델은 답을 문장으로 생성한 뒤 그 결과를 코드가 다시 해석한다. 제브는 반대다. 처음부터 긴 문장을 쓰지 않고 선택지와 확률 같은 결정 자체를 반환한다. 글을 잘 쓰는 AI가 아니라, 소프트웨어가 바로 사용할 수 있는 판단을 빠르게 돌려주겠다는 방식이다. 공개 반응은 컸다. 해커 뉴스에서 큰 토론이 만들어졌고, 확인 시점 기준 1,900포인트와 500개가 넘는 댓글이 달렸다.
잇달아 등장한 오픈소스 구현들
개발자들의 반응은 ‘그럼 이걸 로컬과 오픈소스로 만들면 되지 않을까’로 수렴했다.
- 캡: QN 계열을 기반으로 한 제브 스타일 디시전 모델. 0.8B부터 27B까지 여러 크기를 제공하며, 타입세이프 시스템 API와 호환되도록 만들었다. 아이디어는 직관적이다. 제브를 호출하던 코드를 내 로컬 디시전 서버로 바꿔 꽂는 것.
- 리플렉스: 비슷한 방향이지만 철학이 드러나는 구현이다. 서포트 티켓 같은 상태와 ‘어느 팀으로 보낼까, 사람에게 넘길까, 얼마나 긴급한가’ 같은 질문을 함께 넣으면 각 선택지의 확률을 한 번에 반환한다. 긴 문장을 생성하지 않고, 프로젝트 설명 기준 단일 포워드 패스로 처리하며 기본 모델에서 약 200ms 수준의 응답을 보고한다.
- 애니제브: 새 디시전 모델을 따로 만들지 않는 접근이다. 기존 LLM의 로짓이나 히든 스테이트를 읽어 제브 스타일 판단 엔드포인트로 바꾼다. 이 프로젝트가 강조하는 핵심은 캘리브레이션이다. 모델이 90%라고 말했으면 비슷한 경우에 실제로도 대략 90% 맞아야 그 확률을 자동화에 쓸 수 있다. 캘리브레이션을 적용하면 낮은 위험 기준으로 자동 판단할 수 있는 비율이 크게 늘어난다는 결과도 공개됐다.
- 라이언: 스스로를 비자동회기 기반 디시전 엔진이라고 소개한다. 문장을 한 토큰씩 생성하는 대신 여러 선택지를 한 번에 평가하고, 다국어 지원과 빠른 응답을 전면에 내세운다. 제브를 흉내 내는 프로젝트를 넘어 디시전 모델 자체가 별도 카테고리가 될 수 있음을 보여주는 사례다.
여기서 흐름은 모델을 넘어섰다. 올라라는 프로젝트는 이런 오픈 디시전 모델을 올라마처럼 풀하고 런하고 서브하는 경험을 만들며 타입세이프 호환 API와 MCP 연결까지 제공한다. 네 구현의 내부 설계는 모두 다르지만 방향은 같다. 긴 자유형식 텍스트 대신 정해진 선택지·점수·예/노 같은 결정을 빠르게 반환하고, 그 결과를 확률과 함께 코드가 바로 쓰게 하자는 것.
남은 검증 과제와 논쟁
오픈소스가 나왔다고 제브가 끝난 것은 아니다. 남은 질문은 명확하다. 처음 보는 도메인에서도 얼마나 잘 판단하는지, 확률이 실제 정답률과 얼마나 맞는지, 더 어려운 문제에서도 성능이 유지되는지. 해커 뉴스의 논쟁도 이 지점에서 갈린다. 예전 분류 모델과 본질적으로 무엇이 다른가라는 회의적 의견, 그리고 별도 학습 없이 다양한 도메인에서 바로 쓰는 범용성이 핵심이라는 반론. 승자가 정해진 단계가 아니라 무엇을 제대로 측정해야 하는지가 선명해진 단계다.
아키텍처가 바뀌는 방식
이 흐름의 가장 중요한 함의는 구조적이다. 지금까지는 라우팅할지, 안전한지, 재시도할지 같은 작은 판단도 큰 LLM 하나에게 전부 맡기는 경우가 많았다. 앞으로는 이런 반복 판단을 작고 빠른 디시전 모델이 먼저 처리하고, 애매하거나 정말 어려운 문제에서만 큰 추론 모델을 호출하는 구조가 자연스러워질 수 있다. 작은 모델은 판단하고, 큰 모델은 어려운 문제에 집중한다.
개발자가 지금 볼 것은 세 가지다. 내 앱에 반복되는 판단이 많은가, 그 판단을 초이스·예/노·스코어처럼 명확하게 표현할 수 있는가, 신뢰도가 낮을 때만 큰 모델이나 사람에게 넘길 수 있는가. 세 가지가 모두 보인다면 이 흐름은 AI 뉴스가 아니라 실제 아키텍처 힌트다. 제브 이후의 진짜 질문은 어떤 모델이 최고인가가 아니라 어떤 판단을 어디에서 처리할 것인가에 가까워진다.
보는 포인트
- 문장 생성이 아니라 결정 반환: 기존 LM 파이프라인과 디시전 모델 파이프라인의 차이
- 캡·리플렉스·애니제브·라이언의 서로 다른 구현 전략(로컬 모델, 단일 패스, 로짓 재활용, 비자동회기)
- 캘리브레이션: ‘90%라고 말한 경우 실제로 90% 맞아야’ 자동화가 가능하다는 조건
- 작은 디시전 모델 + 큰 추론 모델의 계층 분업이라는 새 아키텍처 패턴
- 해커 뉴스 논쟁(분류 모델과의 차이 여부)이 가리키는 아직 열린 검증 과제
원본 정보
- 채널: 코드브릿지
- 게시일: 2026-09-26
- 영상: https://www.youtube.com/watch?v=GEvaXpJGiVA
- 길이: 약 5분 · 조회수 약 4,400 회 (2026-09 기준)
- 유의: 본문 수치와 오픈소스 프로젝트명(캡·리플렉스·애니제브·라이언·올라 등)은 자막 음차 기반이라 실제 철자와 다를 수 있다